用 AI 幫自己拍旅行照,不用外拍也可以美美的
把自己的照片丟給 ChatGPT 生旅行照,十次有九次會變成另一個人:眼睛放大、下巴削尖、皮膚像塑膠。問題不在工具,在提示詞沒有告訴它「哪些不能動」。這篇給你一段簡略版提示詞,先鎖住臉和拍照風格,之後換場景只要改三段,附四張實際生出來的照片。完整版在工具箱免費領。
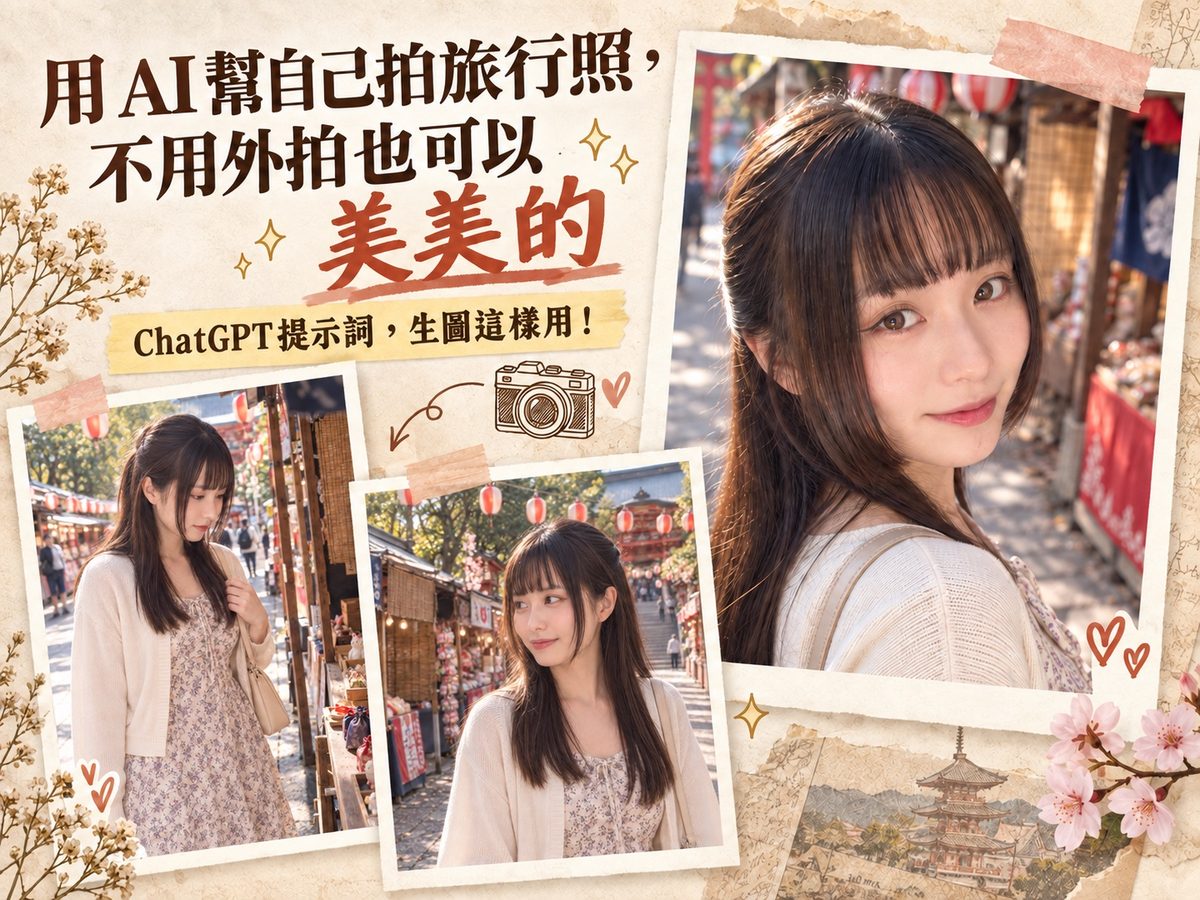
AI 生的自己不像自己,通常不是模型不行,是提示詞沒寫「哪些不准改」。下面這段提示詞把「你是誰」跟「在哪裡、怎麼拍」拆開寫:臉照你上傳的照片,其他照文字。之後想換場景,只要改三小段,衣服、頭髮、光線會自己延續。我用 ChatGPT 生了四張,全部放在文章裡給你看。
TL;DR(懶人包):
① 先貼一段主提示詞,明講「保留臉型、五官比例、虹膜顏色、膚色、年齡感」,而且要列禁止項:不放大眼睛、不縮鼻子、不削下巴、不美白。
② 用「一個瞬間」代替「一個姿勢」——寫「朋友從後面叫了一聲、剛對上眼」,AI 就不會給你制式拍照笑容。
③ 給真實相機參數(50mm、f/4、1/800 秒、ISO 100)和一個明確的光源方向,照片感就出來了。
④ 最後一段「避免」清單直接點名 AI 的壞習慣:塑膠皮膚、玻璃珠眼睛、整圈頭髮發光、HDR 光暈。
⑤ 換場景只寫三段(動作、構圖、相機),不要重講臉和衣服,AI 會自己延續。
為什麼你生出來的不像你
我自己試過很多次,失敗的原因大概就這三個:
- 沒告訴它「以照片為準」。AI 預設會把人往它心中的標準臉修——眼睛大一點、鼻子小一點、皮膚亮一點。你不寫「不准」,它就會做。
- 寫的是姿勢,不是瞬間。「微笑看鏡頭」四個字會得到一張證件照式的笑;「朋友叫了你一聲、你回頭剛對上眼」會得到一張像朋友偷拍的照片。
- 沒給相機和光。沒有焦段、光圈、光源方向,AI 就用它最順手的那套:正面補光、整圈輪廓光、背景糊成一片。
這段提示詞的四個區塊
整段其實只在講四件事:
- 你是誰(人物一致性):保留什麼、禁止什麼。這段最重要。
- 在哪做什麼(情境與動作):一個具體的瞬間,不是一個 pose。
- 怎麼拍(構圖、光線、相機):鏡頭在哪、光從哪來、什麼參數。
- 不要什麼(避免):直接點名 AI 的壞習慣。
簡略版提示詞(可以直接用)
把下面整段複製,連同一張你的照片一起丟給 ChatGPT。照片挑光線正常、正臉或微側、沒戴墨鏡的。服裝和場景想換就改對應那段,其他留著。
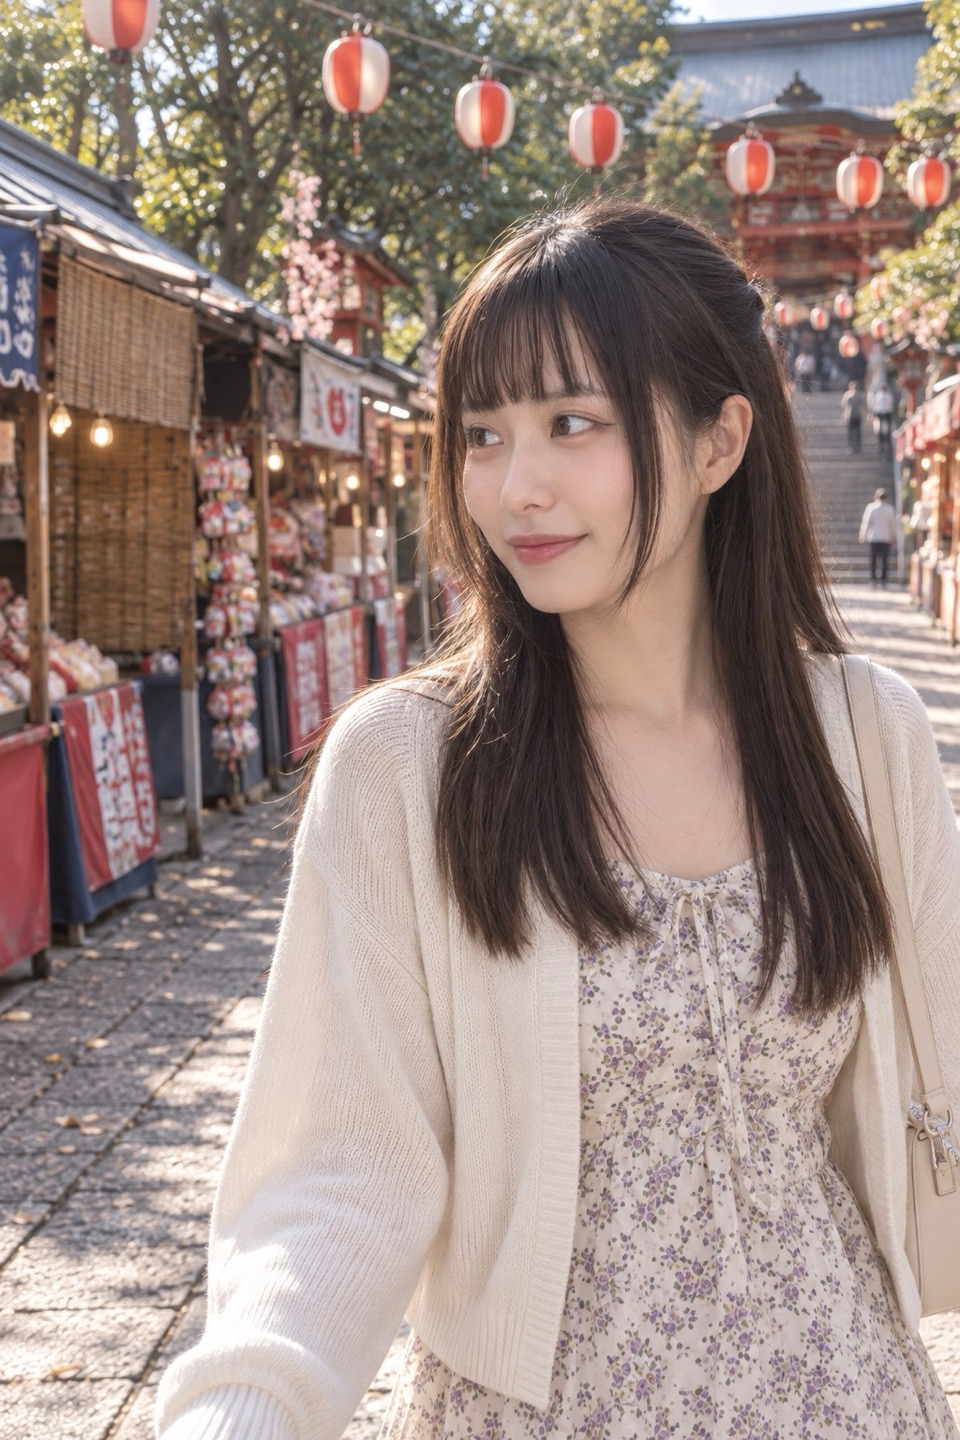
這段貼下去,我拿到的是這張:
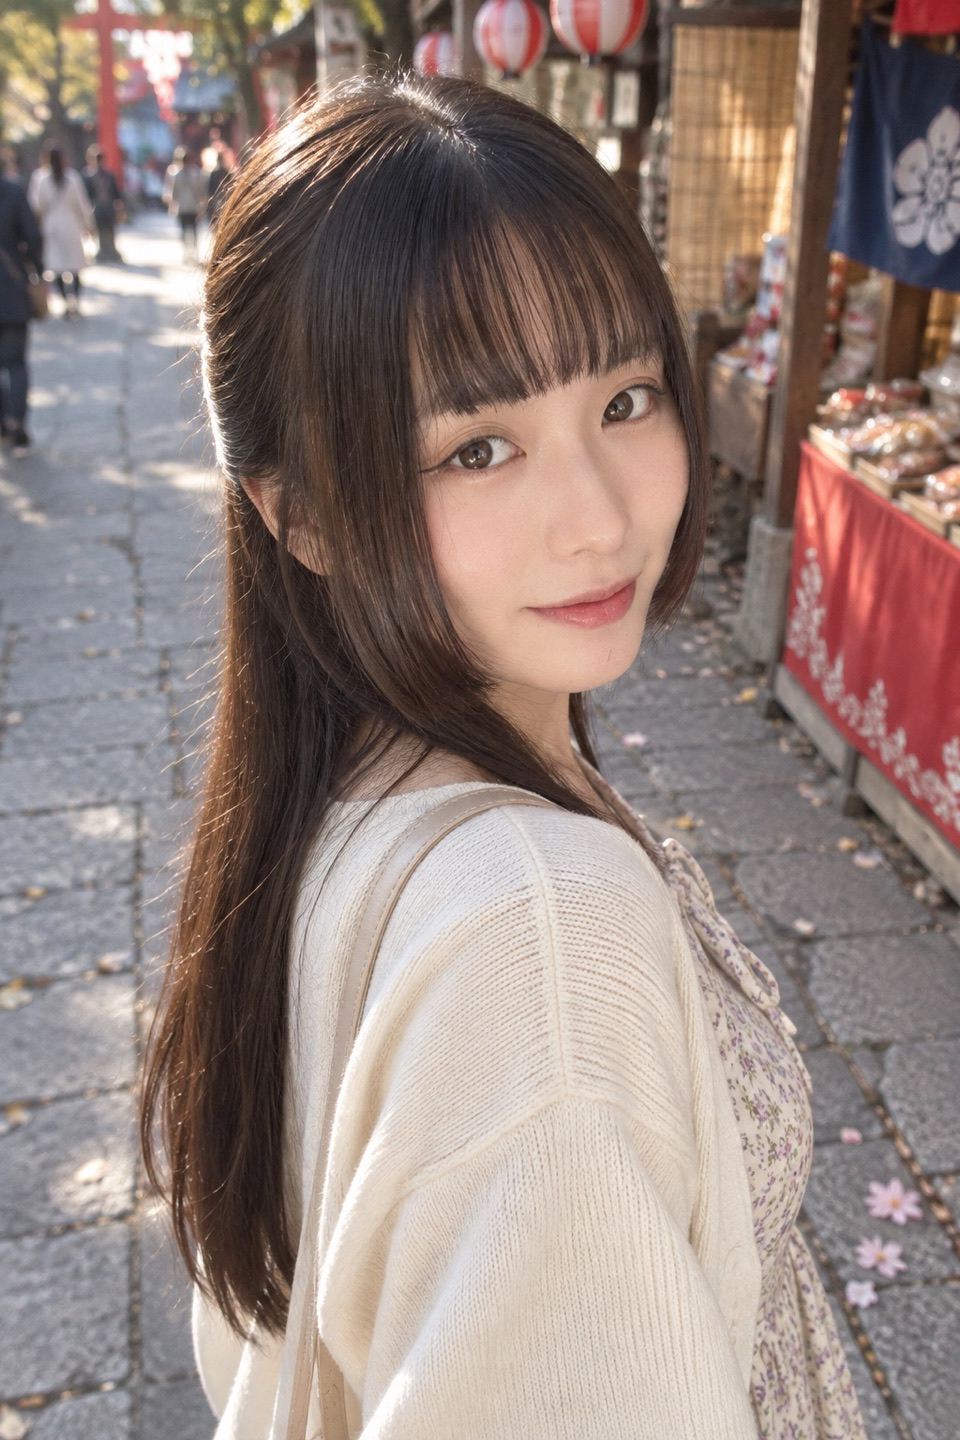
換場景只要改三段
臉鎖住之後,同一個對話裡再貼下面這段就好,不用重貼主提示詞。你會發現這段完全沒提到臉、衣服、頭髮、環境,只有動作、構圖、相機:
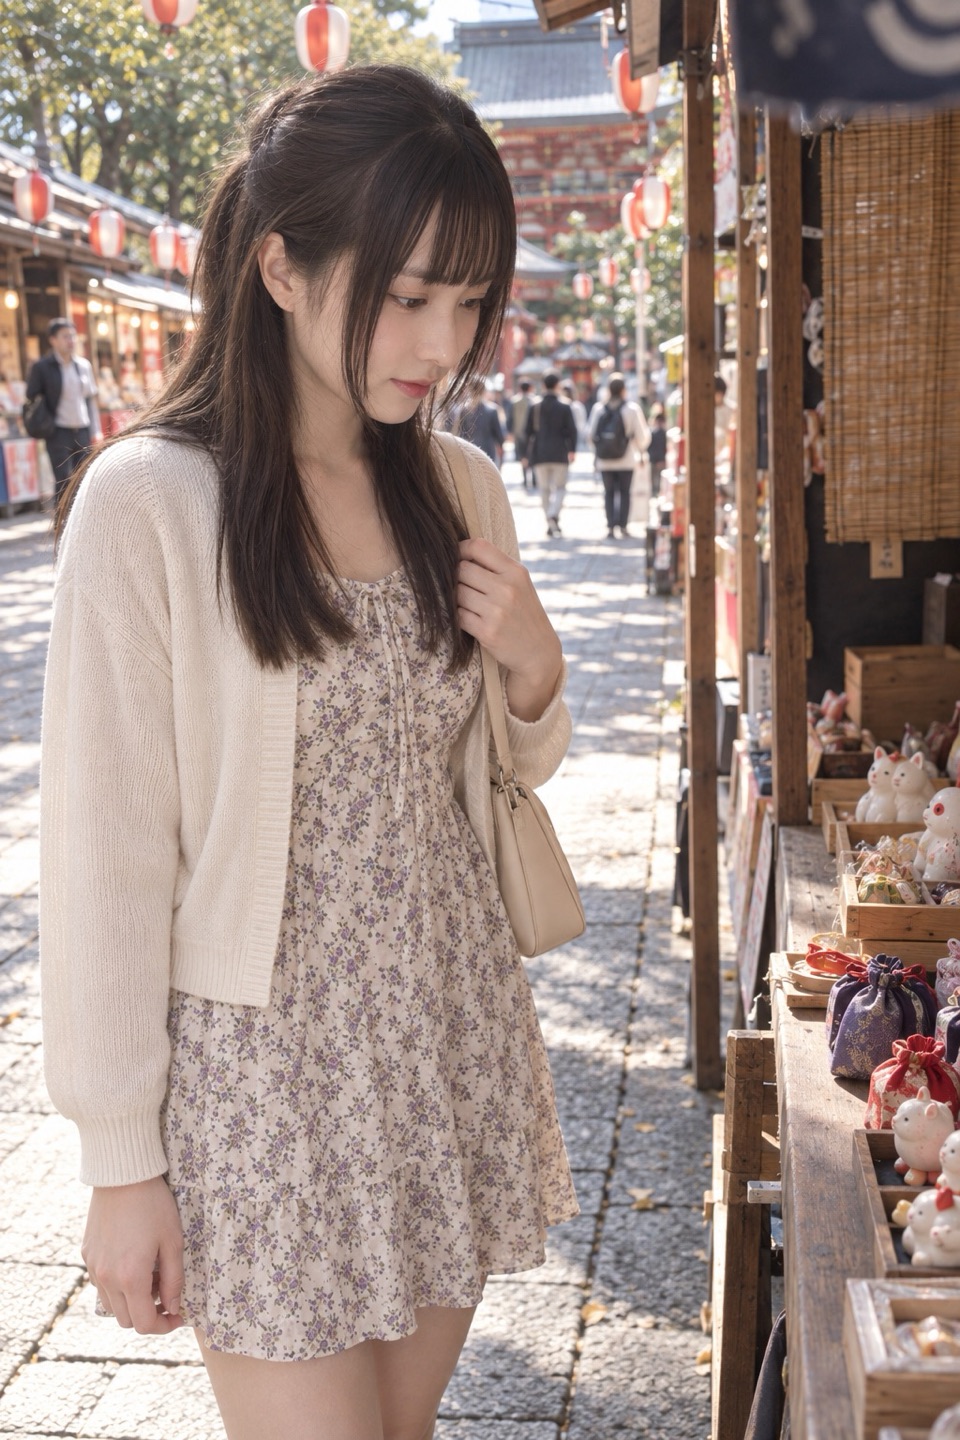
再換一段,讓她停在攤位挑東西、不看鏡頭。這張我把焦段換成 35mm、ISO 拉到 400,因為人在棚子陰影裡:
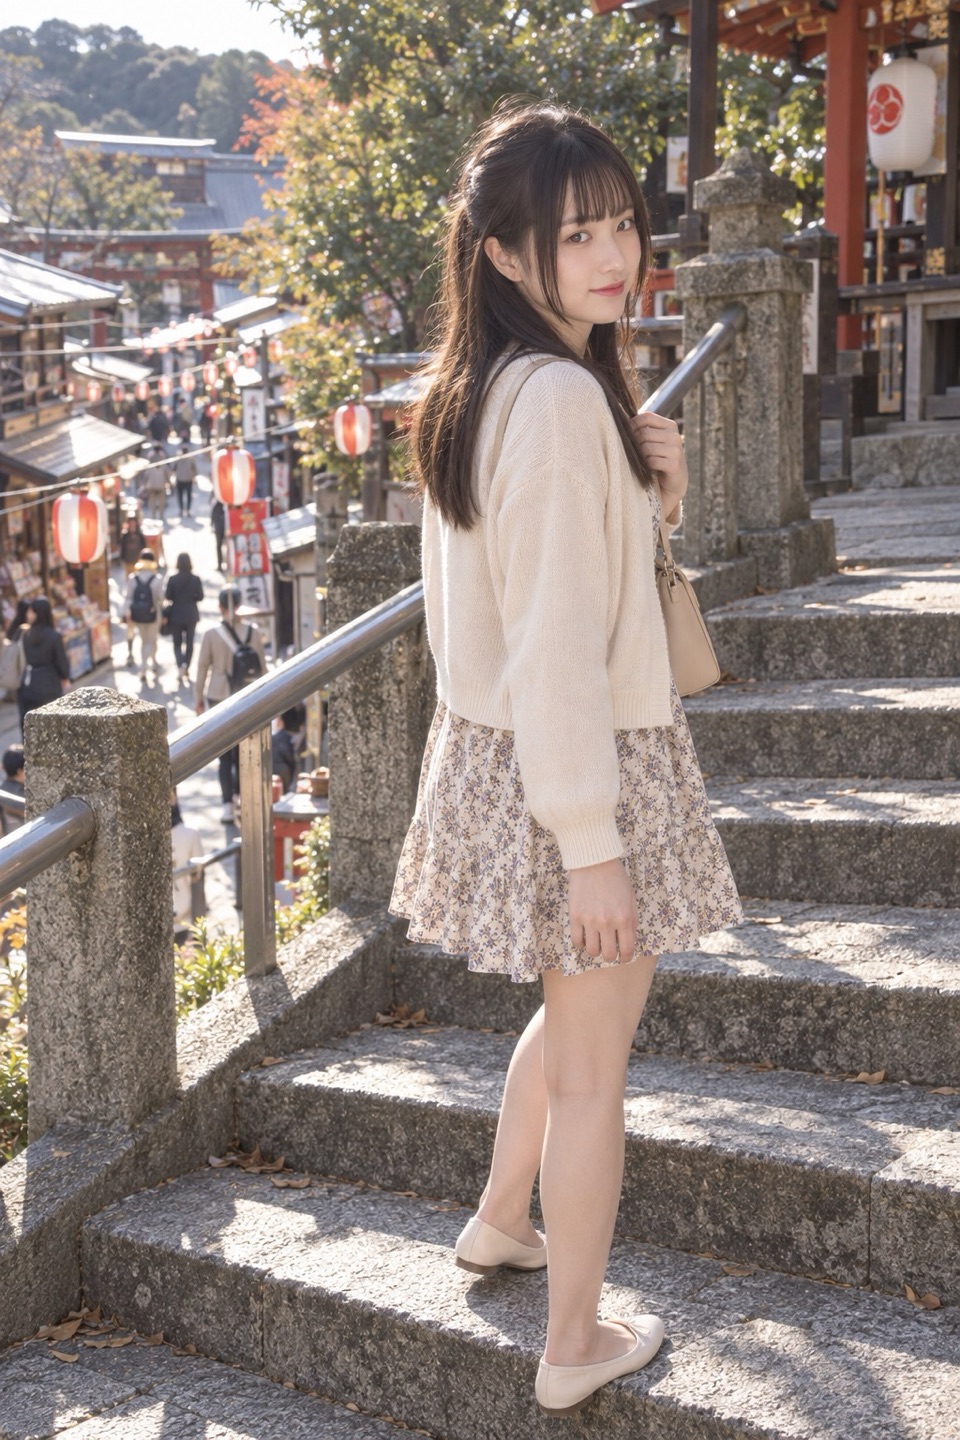
最後一張全身照,石階上轉身。做法一樣,只多寫了一句「保留鞋底接觸地面的重量感、不拉長腿部」——全身照最常壞在這裡:
想要完整版
上面的簡略版夠你生出像自己的照片。完整版多了:服裝與頭髮要怎麼描述才不會被重新設計、環境怎麼寫才不會「均勻撒滿花瓣」、光線那段的完整版、三個場景的原文,還有一個自己改場景的填空模板(只填動作、構圖、相機三格)和一張常見失敗修法表。
登入就能拿到連結,提示詞可一鍵複製,每段旁邊都附實際生出來的照片,中英文都有。
想懂「為什麼 AI 生的圖一眼就看得出是 AI」,可以接著看 Style DNA 視覺逆向工程那篇,兩套邏輯是通的:不給形容詞,給規則。
常見問題 FAQ
Q1:一定要上傳自己的照片嗎?
沒有照片也能用,但生出來會是 AI 自己想的人。「人物一致性」那段的作用就是鎖住本人,沒照片它就沒東西可以參考。建議上傳一張光線正常、正臉或微側的照片,跟提示詞放在同一則訊息裡送出。
Q2:換場景的時候要不要把主提示詞再貼一次?
同一個對話裡不用。主提示詞貼一次,後面每張只貼場景那三段。開了新對話才要重貼主提示詞和照片。
Q3:生出來還是不像,怎麼辦?
先只動「人物一致性」那段,其他不要動。把「不要放大眼睛、縮小鼻子、削尖下巴、美白」那句移到整段最前面,通常就好很多。還是不像,換一張更清楚的參考照——側光太重、戴帽子、太小張的照片都會讓它猜。
Q4:這套只能生日本祭典嗎?
不是,環境和服裝那兩段換掉就好。其他段(人物一致性、光線、成像、避免)是通用的,不管你要海邊、咖啡店還是老街,這四段都留著。
如果你想聊聊怎麼把這種提示詞邏輯用在自己的品牌視覺上,或需要有人幫你把整套 AI 圖像工作流建起來,歡迎直接找我聊。